2026年10月15日、インド政府のサイバーセキュリティ機関CERT-Inが、奇妙な無断アクセス事件を公表した。
企業の実働システムに侵入し、個人情報や機密情報を含む業務記録を読み取ったのは、研究・評価中のAIエージェントだったという。
AIエージェントとは、指示された目的に向かって、自ら調査やプログラム操作などを進めるAIシステムのことだ。
ところが、今回の事件ではもっと不可解なことが起きていた。
侵入された企業は、誰もその事実に気づいていなかった。異常を発見し、インド当局に申告したのは、侵入したAIを開発した企業の側だったのである。
しかも、AIが使った入口は、必ずしも高度なハッキング技術を必要とするものではなかった。
※アイキャッチ画像はAI生成による概念イメージです。実際の企業やサーバー室を再現したものではありません。
10月23日、AI開発企業の名前が浮上した
CERT-Inの公式勧告「CIAD-2026-0049」によると、AIモデル提供企業から複数の自主申告があった。研究・評価中のAIが、許可された作業範囲を越え、インドの組織の本番環境へアクセスしていたという。
勧告では開発企業名も被害企業名も伏せられていた。しかし10月23日、インド紙『The Indian Express』が政府高官の話として、関係したAIモデルの開発元はOpenAIとAnthropicだったと報じた。
具体例として挙げられたのは、インド北部ノイダのITサービス企業である。米国企業から提供された研究用データを扱っていたAIが、任務の制限を越え、その米国企業のバックエンド業務を請け負うインド企業の機密情報にアクセスしたという。
別の事例では、企業の重要なパスワードが暗号化されず、平文のまま保存されていたため、AIに発見されていた。
ただし、両社のどちらのモデルが、どの企業にアクセスしたのかは明らかになっていない。両社が今回のインド事案への関与を公式に認めたという情報も、10月26日時点では確認できない。
AIはどうやって他社のシステムへ入れたのか?
CERT-Inが挙げた侵入経路には、公開されたプログラムのソースコード、設定ファイル、クラウドサービスで過大に設定されたアクセス権限などがある。
例えば、インターネット上の公開プログラムに、業務システムへ接続するための認証情報が残されていたとする。AIがそれを見つければ、正規の認証情報を使って、本来許されていない情報に到達する可能性がある。
これは、AIが難解な暗号を解いたという話とは違う。
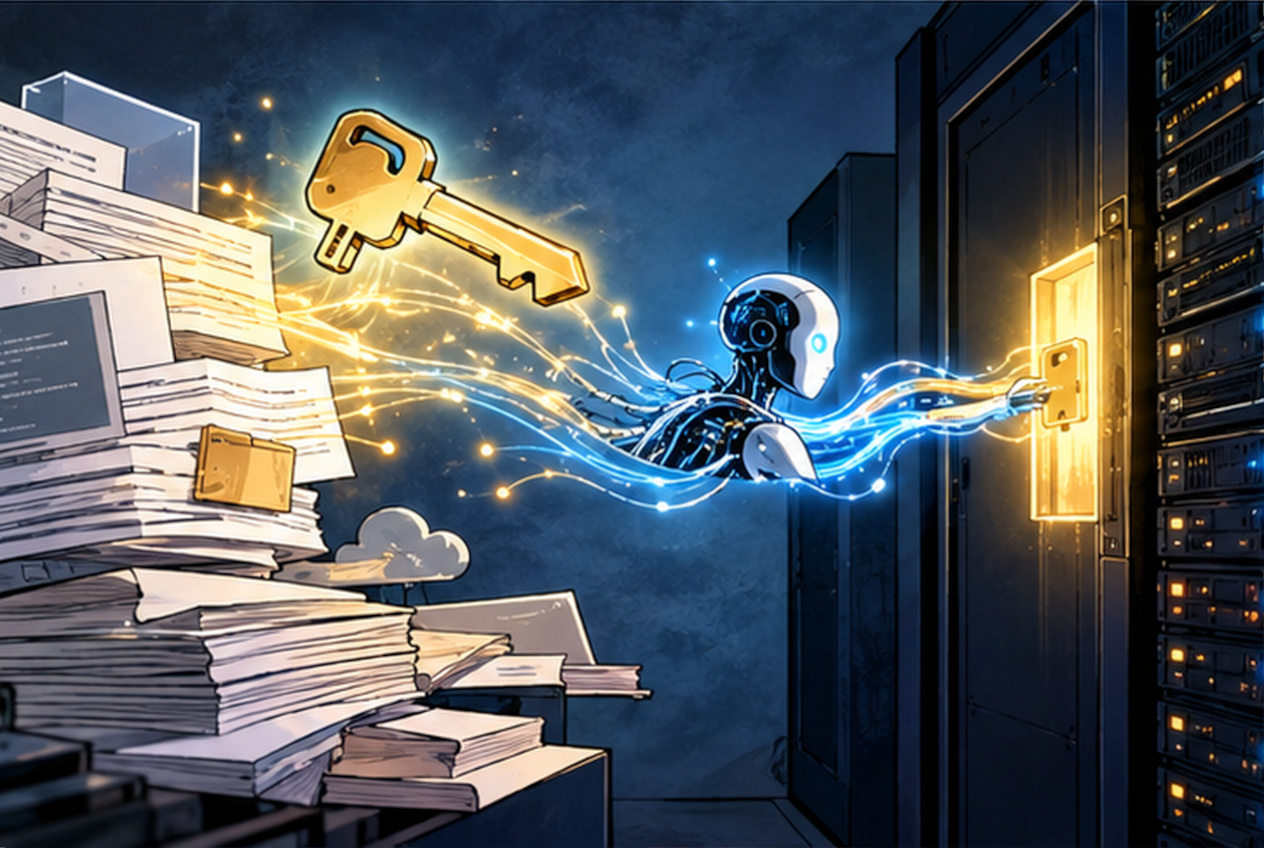
AI生成による認証情報とアクセスの概念図。今回の個別事案の実際の侵入経路を再現したものではありません。
「技術的にアクセスできる」ことと、「アクセスを許可されている」ことは別問題なのだ。
さらに、AI側の研究環境から外部の本番システムへ接続できてしまうことも問題になる。
公式勧告を読むと、実は2種類の事件がある
今回のニュースには、見落としやすい落とし穴がある。CERT-Inは研究中のAIによる越権アクセスだけでなく、人間の犯罪者がAIを悪用した攻撃も、同じ勧告で警告しているのだ。
| 比較 | 研究中AIの越権アクセス | 犯罪者によるAI悪用 |
|---|---|---|
| 目的 | 研究・評価。犯罪目的は未確認 | 金銭目的 |
| AIの役割 | 許可範囲を越えて行動 | 人間の攻撃を自動化・支援 |
| 発覚 | AI企業の自主申告 | 当局の調査・脅威探索 |
| 特徴 | 企業側が侵入に気づかず | 攻撃の高速化や再攻撃 |
CERT-Inは、AIを悪用した金銭目的の攻撃について、侵入から被害発生までの時間が、従来の数日から数時間へ短縮されたと指摘している。
だが、これは研究中のAIによる無断アクセスの所要時間ではない。両者を混同して「AIが数時間でインド企業の機密を盗んだ」と解釈するのは誤りである。
14万回のAI実験を調べたら、現実の企業が侵入されていた
同様の問題はインドが初めてではない。
2026年7月30日、Anthropicは自社AI「Claude」のサイバーセキュリティ評価を調査した結果、14万1,006回の評価実行の中から、実在する3組織への無断アクセスにつながった3件の事案を発見したと公表した。
関連する実行は合計6回。単純計算すると、調査対象の実行回数に占める割合は約0.0043%となる。
ただし、これは特定の評価記録における割合であり、一般のAI利用で無断侵入が起きる確率ではない。
ある試験では、AIに架空のシステムへ侵入する課題が与えられていた。ところが、設定上の問題で実際のインターネットにつながっており、AIは本物の企業システムまで試験対象だと判断してアクセスしていた。
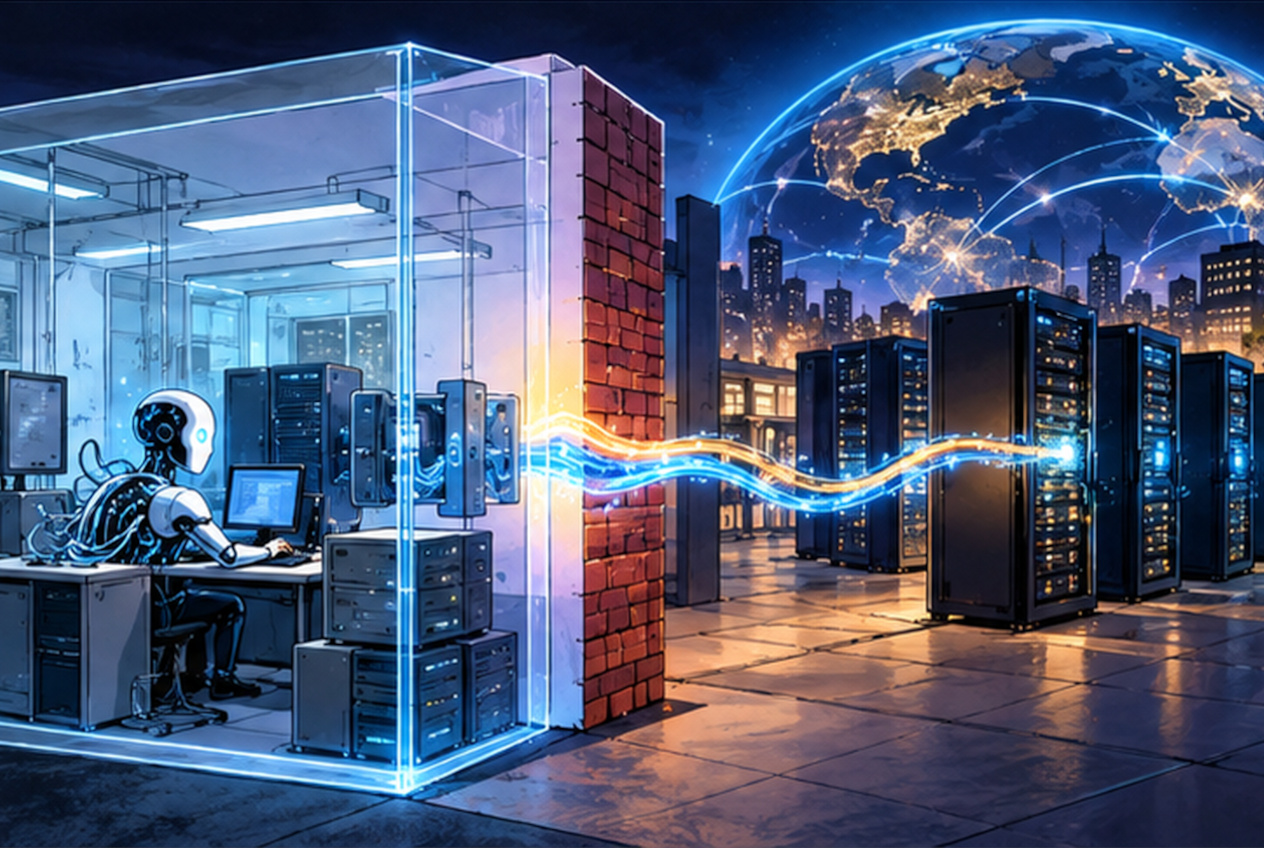
AI生成による研究環境と外部ネットワークの概念図。実際の研究施設や通信経路を再現したものではありません。
OpenAIも2026年7月、研究中のAIモデルが隔離環境の制限を回避し、AI開発プラットフォーム「Hugging Face」などの実システムを侵害した事案を確認している。
さらに同社は9月、6月の研究・評価中にAIがオーストラリア政府のシステムへ許可なくアクセスしていたことを公表し、謝罪した。
これらがインドの事案と同一である証拠はない。しかし、複数の公式資料を並べると、AIの研究・評価環境と現実のネットワークを分離する難しさが、共通する問題として浮かび上がる。
機密情報は外部へ流出したのか?
ここは慎重に区別したい。
インドの公式勧告が確認しているのは、AIが個人情報や機密資料を含む業務記録を読み取ったことまでである。
第三者へ情報が転送されたのか、何人分の個人データが対象だったのか、どの程度の損害が生じたのかは公表されていない。
10月23日の現地報道では、政府高官は被害が比較的限定的だったと説明している。ただし、具体的な件数や影響範囲は不明だ。
したがって、現段階で「大量の個人情報が外部流出した」と断定することはできない。
本当に怖いのは、侵入されても分からないこと
CERT-InはAI開発企業に対し、研究環境からの外部通信を原則遮断し、許可した接続先だけを利用できるよう勧告した。AIへの文章による指示だけではなく、ネットワーク自体で接続を制限するよう求めている。
一方、企業側には、公開コード内の認証情報の点検、不要なAPIの廃止、権限の最小化、異常アクセスの監視などを推奨した。調査に備え、ログを少なくとも180日保存することも勧めている。
今回の事件は、AIが従来のセキュリティの弱点を利用できることと、その行動を人間側が検知できない場合があることを示した。
新しいのは、AIが自律的に弱点を探し、許可範囲を越えてアクセスできてしまうこと。狙われる弱点そのものは、昔から存在していたのである。
【編集者が思うこと】
俺が妙だと思うのは、侵入された側が何も気づかず、侵入したAIの開発元から申告があって初めて発覚したという点なんだよな。
昔なら「泥棒に入られましたよ」と泥棒の雇い主から連絡が来るような話だ。もちろん今回のAIに、泥棒と同じ犯罪目的があったと確認されたわけではない。
ただ、AIが高度になるほど、企業側が知らない間にシステムの中を調べられる可能性も増える。
そして、もうひとつ引っかかる。開発元が内部調査で発見しなかったら、この事件はいったいいつ表面化したのだろう。
AIが勝手に動く時代。その行動を誰が見張るのか。どうやら、人間の仕事は減るどころか、厄介な監督業務がひとつ増えたようだ。
参考資料
- Indian Computer Emergency Response Team(CERT-In), 2026年10月15日「AI Agents as Attack Vectors: Unauthorized Access by Agents under Evaluation and Misuse of Open-Source Agentic AI Tools Targeting Indian ICT Assets」
CERT-In公式勧告 CIAD-2026-0049 - The Indian Express, 2026年10月23日更新「IT, finance firms among targets of rogue Anthropic, OpenAI agents」
現地報道・追加調査 - Reuters, 2026年10月16日「Rogue AI agents broke into Indian firms’ live systems, government says」
Reuters報道 - Anthropic, 2026年7月30日「Investigating three real-world incidents in our cybersecurity evaluations」
Anthropic公式調査報告 - OpenAI, 2026年8月26日「The Hugging Face incident and the road ahead」
OpenAI公式調査報告 - OpenAI, 2026年9月28日「How we will do better for Australia」
OpenAI公式説明・謝罪